當硬體受限逼出數學的極致優雅:從冷戰 B-58 轟炸機的 CORDIC 演算法,看當代邊緣計算與 SLM 的文藝復興
為了解決冷戰時期超音速轟炸機座艙塞不下電冰箱大小乘法器的困境,工程師發明了純靠位移與加法的 CORDIC 演算法。這段推導不僅展現了極限約束下的數學極簡之美,更給了當代面對記憶體頻寬瓶頸的 SLM 與端側邊緣計算深刻的啟發。
今天在思考小型語言模型(SLM)部署在端側邊緣裝置的困境時,與 AI 深入討論到了關鍵瓶頸——記憶體頻寬限制(Memory Bandwidth Wall)。在探討如何透過記憶體內計算(In-Memory Computing / CiM)與降低硬體乘法計算量的過程中,一個曾經在微控制器(MCU)規格表上看過卻未曾深究的名詞跳了出來:CORDIC。
好奇之下追問了它的歷史背景與數學推導過程,整個震撼湧上心頭。這是我工程生涯中,少數幾次真切感受到「數學竟然可以如此優雅、如此貼合硬體物理本質」的時刻。
一、 誕生背景:冷戰時期的航太導航危機
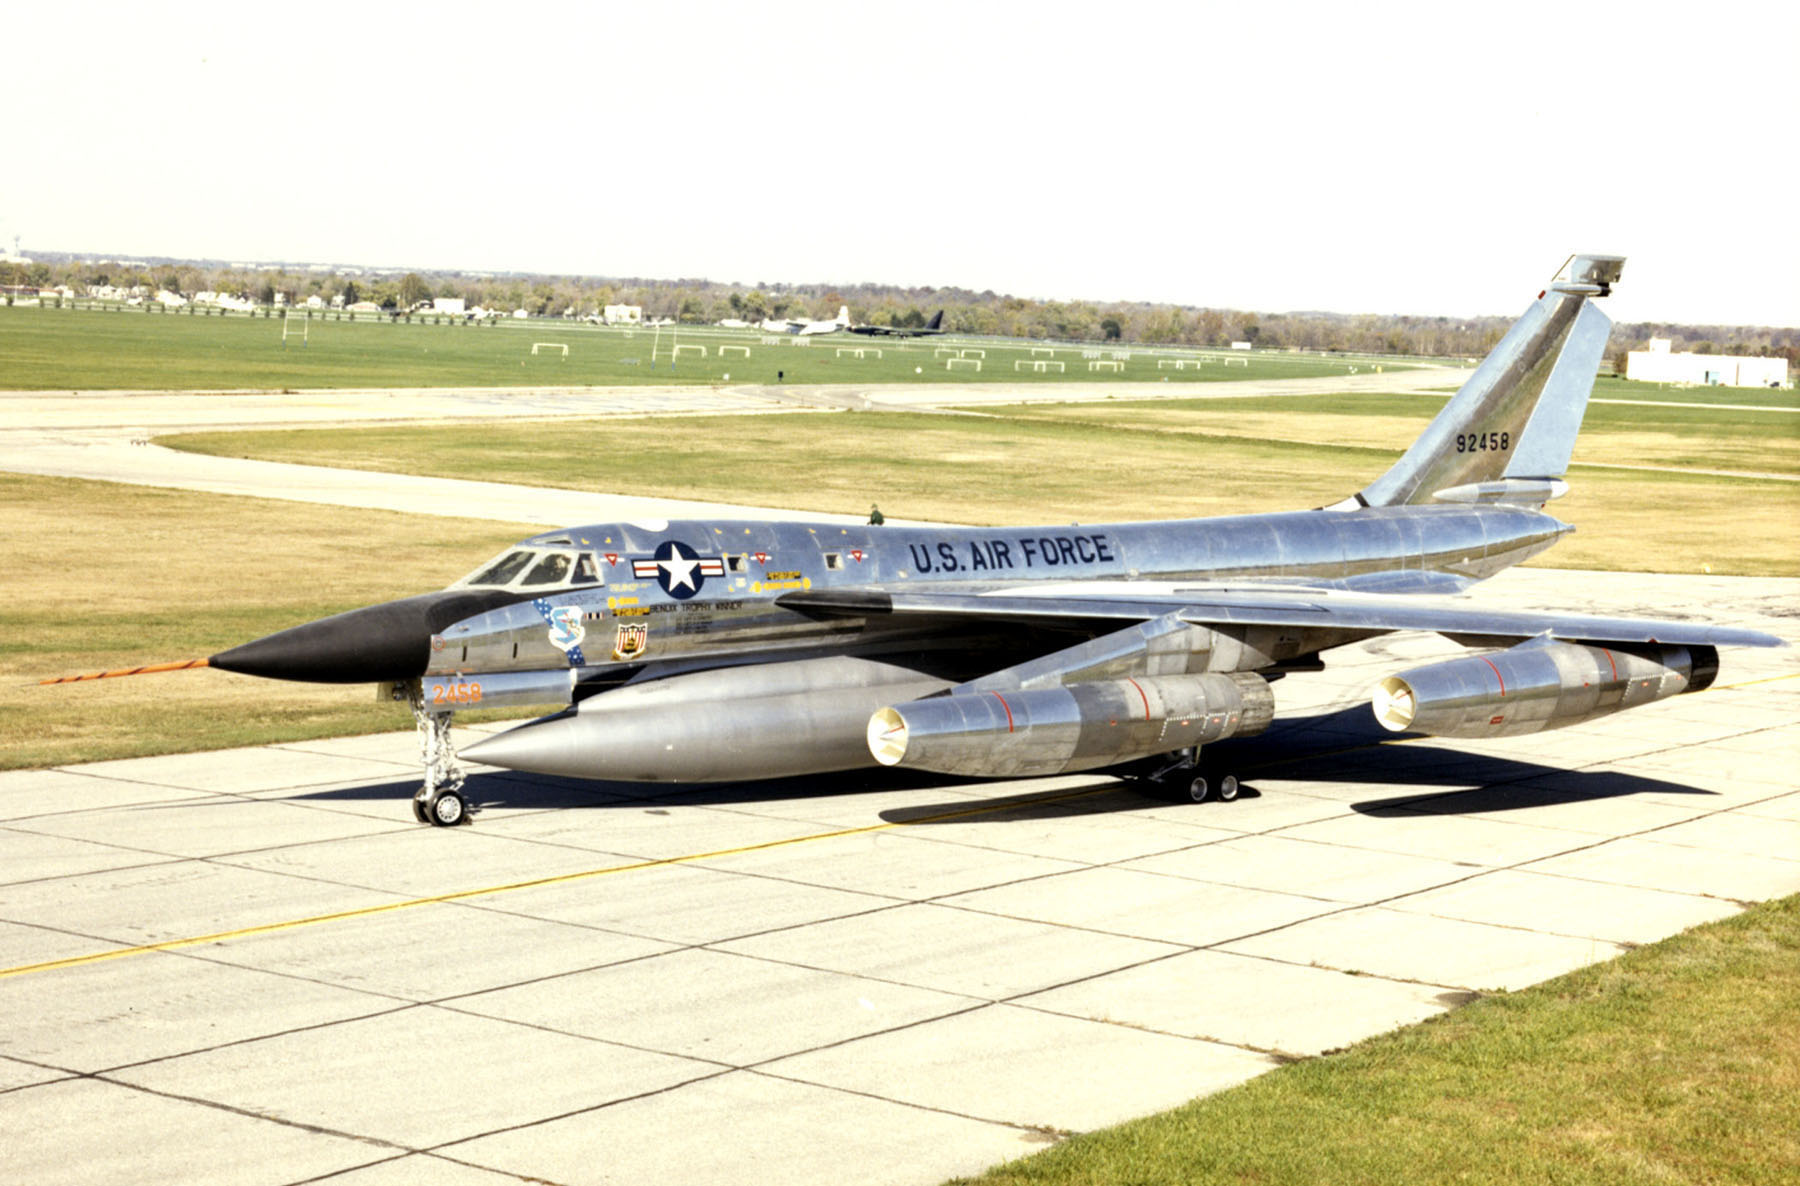
CORDIC(Coordinate Rotation Digital Computer,座標旋轉數位計算機)誕生於 1950 年代末期,由美國康維爾公司(Convair)的工程師 Jack E. Volder 所發明。
當時正值冷戰高峰,美國正全力研發 B-58「盜賊」(Hustler)超音速轟炸機。在超音速飛行下,機載導航系統必須即時將陀螺儀與雷達的二維/三維姿態座標,旋轉對齊到地球經緯度座標。然而,工程師們撞上了一堵無情的物理之牆:
- 類比計算機:精度極差,且在高空震動與溫差下漂移嚴重。
- 早期的數位計算機:那時剛問世的數位真空管或電晶體電腦,光是一個能做乘除法的硬體單元,體積就相當於一台家用大電冰箱,算一次浮點乘除法耗時漫長。
- 極端限制:B-58 駕駛艙空間狹窄、配重極度嚴苛,根本塞不下龐大的數位乘法硬體,但導航卻要求毫秒級別的即時三角函數運算。
Volder 站在白板前思考著一個幾乎違背常理的問題:「有沒有可能在不使用任何硬體乘法器、除法器的前提下,只靠『加法』和『位移』,就能在晶片上旋轉一個向量?」
二、 數學的降維打擊:CORDIC 的推導精髓
在二維平面上,將一個向量 (x, y) 旋轉角度 θ 的標準旋轉矩陣如下:
x_new = x * cos(θ) - y * sin(θ)
y_new = x * sin(θ) + y * cos(θ)
這需要 4 次乘法,外加查表計算 sin 與 cos。在硬體乘法器極其昂貴的年代,這條路行不通。Volder 的天才解構分為兩步:
1. 提出公因數 cos(θ),轉為 tan(θ)
x_new = cos(θ) * [ x - y * tan(θ) ]
y_new = cos(θ) * [ y + x * tan(θ) ]
這時括號內的運算元,乘法只剩下 tan(θ)。
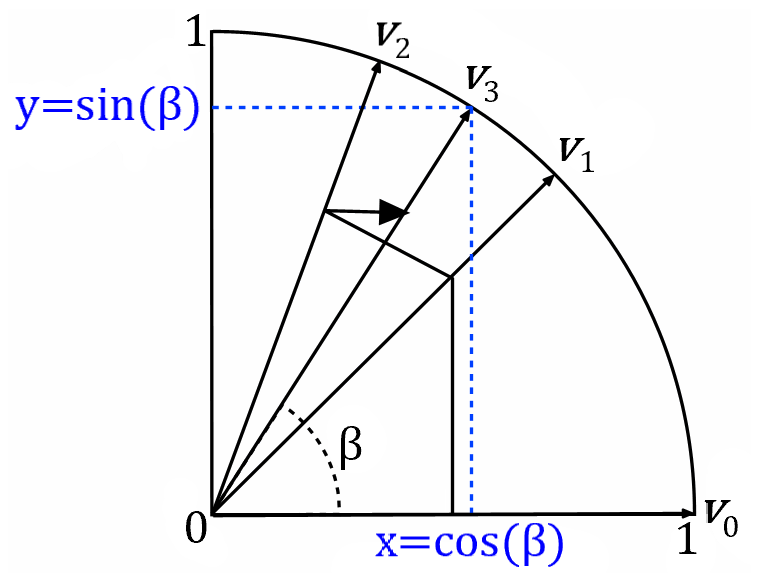
2. 關鍵魔術:強迫 tan(θ) 成為 2 的負次方(Shift-and-Add)
Volder 規定:我們不要一次旋轉任意角度,而是把總角度分解成一連串預設的「微旋轉步驟」θ_i,並且讓每一級微旋轉的 tan(θ_i) = 2^(-i):
- 第 0 步 (i=0):
tan(θ_0) = 2^0 = 1(旋轉 45.0 度) - 第 1 步 (i=1):
tan(θ_1) = 2^(-1) = 0.5(旋轉約 26.565 度) - 第 2 步 (i=2):
tan(θ_2) = 2^(-2) = 0.25(旋轉約 14.036 度) - 第 i 步 (i=i):
tan(θ_i) = 2^(-i)(在二進制硬體中,就是向右位移 i 個 bit!)
這意味著括號內的計算完全退化成:
x[i+1] = x[i] - d_i * (y[i] >> i)
y[i+1] = y[i] + d_i * (x[i] >> i)
z[i+1] = z[i] - d_i * θ_i
其中 d_i 只有 +1(逆時針)或 -1(順時針),純粹取決於當前累積角度與目標角度的正負符號;而 >> i 只是二進制位移(在硬體線路中甚至只需硬連線 Routing,連邏輯閘延遲都沒有)。
3. 模長因數的巧妙消化
那麼提出來的 cos(θ_i) 怎麼辦?每一級旋轉向量會被拉長 sqrt(1 + 2^(-2i)) 倍。但只要迭代次數固定,所有微旋轉的放大係數乘積是一個固定常數 K ≈ 1.64676(倒數 A ≈ 0.60725)!
這代表在硬體旋轉管線中,根本不需要做動態縮放,只要在運算開始前將初始向量乘以常數,或直接在最後階段(甚至在 ADC/DAC 的參考電壓上)做一次固定比例補償即可。
原本需要如電冰箱般龐大的乘除法硬體,被精簡成了一個 Shifter、一個加減法器(Adder/Subtractor)和一張只有幾十個常數的小查表。
三、 工程師的反思:從 MCU 規格到 Edge AI 的文藝復興
以前在閱讀 STM32 等工業級 MCU 規格書時,看到內部整合了硬體 CORDIC 加速模組,總以為只是為了馬達 FOC 控制(Park / Clarke 座標變換)而設計的專用輔助 IP,並未體會到其底層思想的偉大。
但今天重新回顧這段歷史,對比當前 AI 的發展,帶來了強烈的啟發:
- 摩爾定律下的「算力怠惰」:
過去數十年,因為 Dennard Scaling 與製程微縮,硬體乘加器(MAC)又小又便宜,業界習慣用暴力美學堆疊算力、依賴龐大的矩陣乘法(GEMM)與浮點運算。 - 當代端側與 SLM 面臨的物理邊界:
現在當我們要將大型模型壓縮成小型語言模型(SLM),並塞進算力與電池受限的端側裝置時,我們赫然發現又撞上了類似冷戰時期的物理牆——不是算力不足,而是記憶體頻寬瓶頸(Memory Wall)與搬運資料的能耗極限。 - 無乘法計算的文藝復興:
近年來學界與業界熱議的 BitNet b1.58(三值權重 -1, 0, 1)、ShiftAddNet(以位移與加法取代矩陣乘法),以及 SRAM 記憶體內計算(Computing-in-Memory),本質上都在回歸 CORDIC 60 年前的核心哲學:「用進位制與對稱性,找出避開重型乘法器的最短路徑。」
結語
工程最迷人的地方,往往不是無限資源下的堆砌,而是在極致嚴苛的邊界條件下,工程師被迫退回到數學與物理本質,所逼出的極簡解法。
這一次與 AI 的偶遇探索,不僅解開了我對 CORDIC 的認識,更讓我重新體會到:數學從來不是死板的公式推導,而是人類為了突破物理限制所鍛造出最鋒利的思維工具。