從馮紐曼到哈佛架構:一場穿透晶片管線與心智盲區的認知除錯
從馮·紐曼瓶頸與哈佛架構剖析現代 ARM Cortex-M 核心演進,探討晶片設計在物理極限下的戰略折衷,以及打破思維慣性、穿透本質的心智模型重構。
在工程領域與日常生活裡,最危險的狀態往往不是「無知」,而是「誤以為自己全懂了」。
當我們遇到認知斷層時,大腦非常擅長運用過往的零星經驗「自行打補丁腦補」,最後把拼湊出來的假象當作客觀真理。昨夜重溫計算機體系結構(Computer Architecture),從馮·紐曼(Von Neumann)與哈佛(Harvard)架構一路剖析到現代 ARM Cortex-M 核心演進,不僅理清了半導體設計在物理邊界下的折衷抉擇,更是一次對自己思維模型的深度除錯(Debug)。
一、 課本死背的定義,掩蓋了真實的工程代價
教科書上談兩者差異,往往只用一句話帶過:「馮紐曼共用記憶體與匯流排,哈佛則是指令與資料分流」。這種過度簡化的定義,讓人忽略了背後的物理制約與代價折衷。
1. 馮·紐曼架構:極致成本下的匯流排排隊
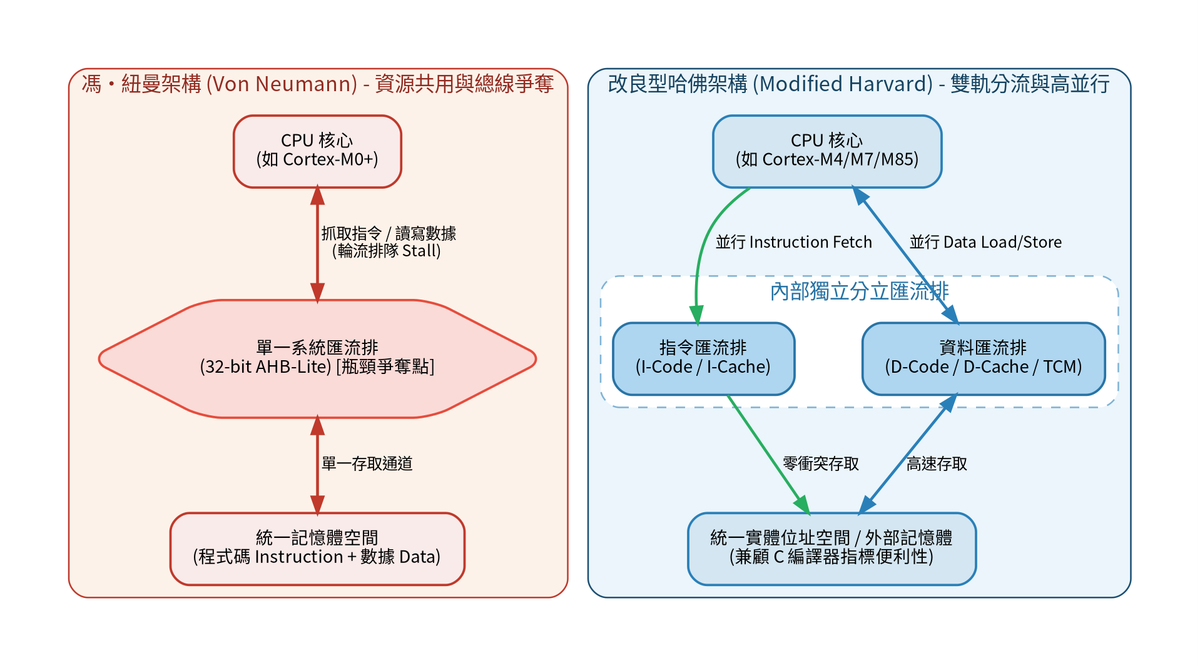
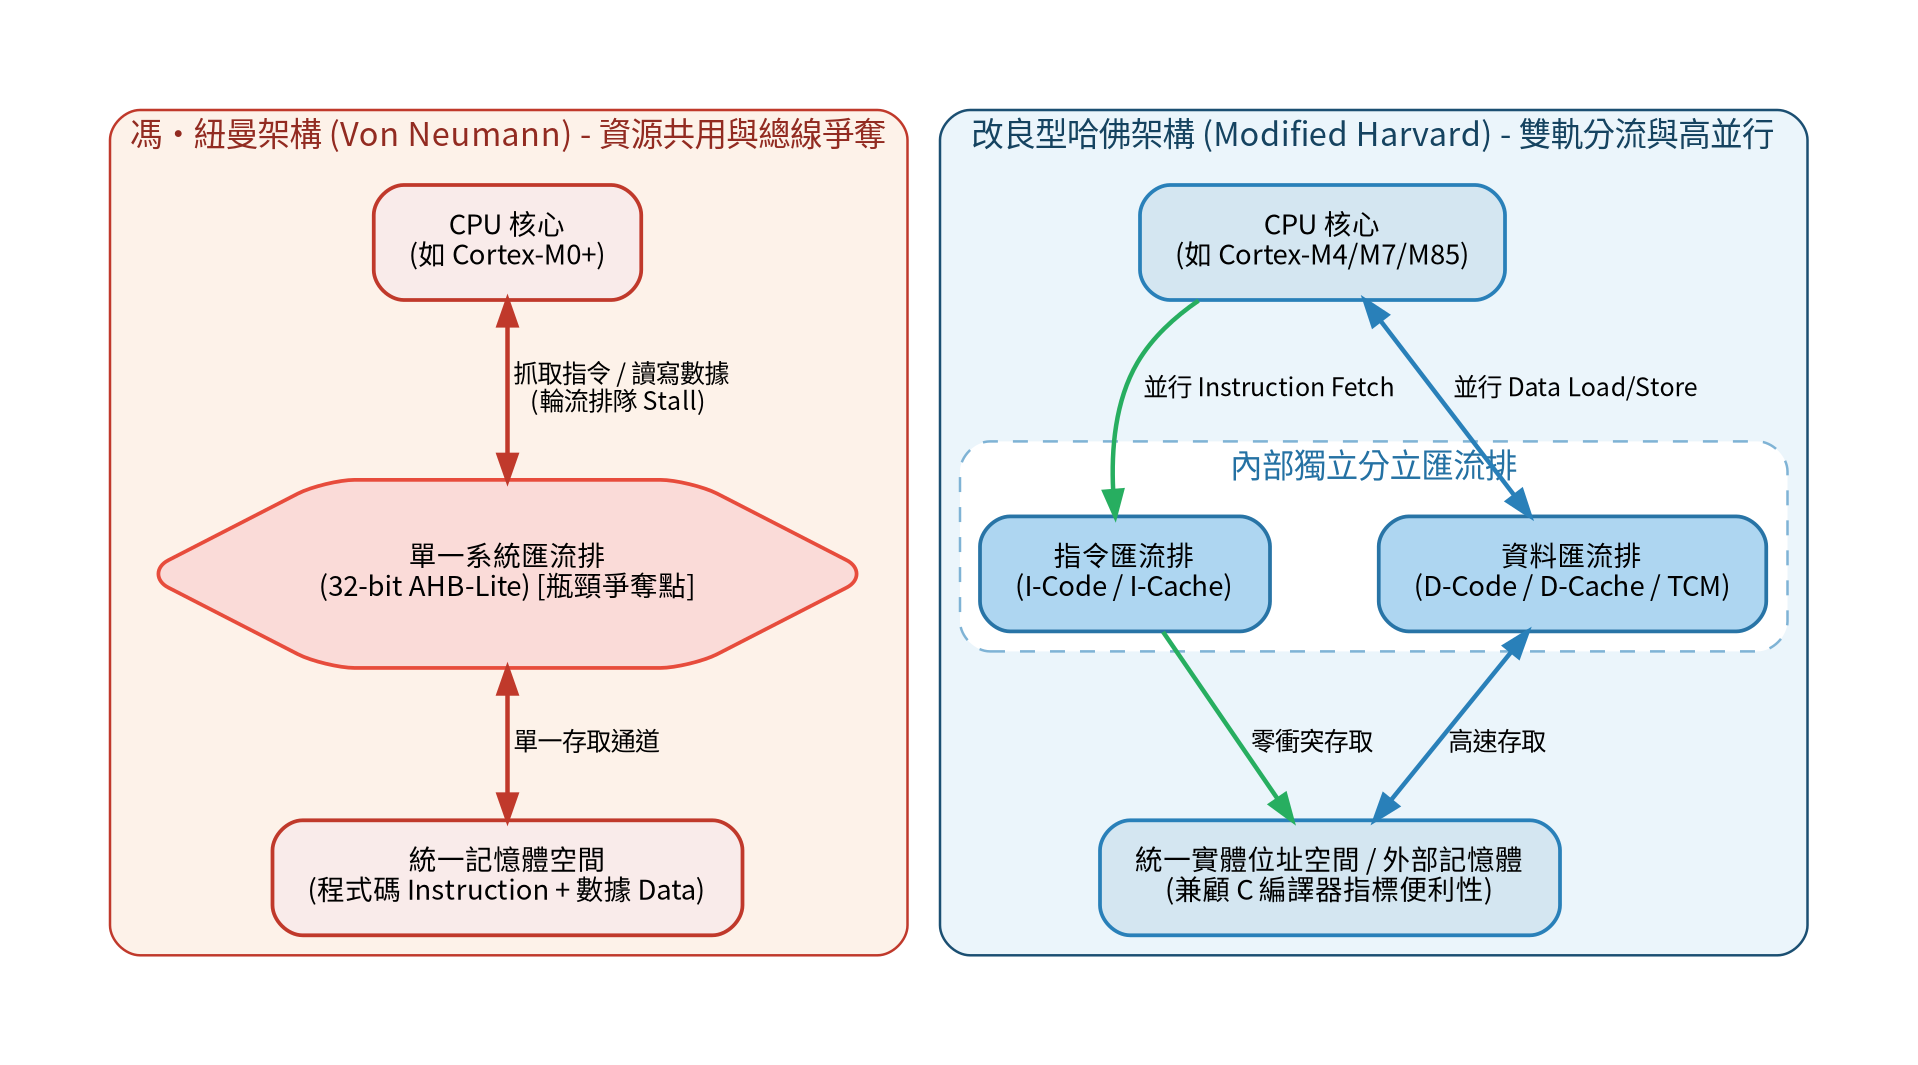
馮紐曼將程式碼與資料放在同一個實體空間、共用一組系統匯流排。在同一個時脈週期內,CPU 無法同時抓取指令與讀寫資料,兩者必須在匯流排前輪流排隊。這就是著名的「馮·紐曼瓶頸」。
但在 Cortex-M0+ 或 M23 這種追求超微型面積(約 1.2 萬閘)與極致低功耗的場景下,單一 32-bit AHB 匯流排正是精準的戰略性犧牲——以效能停頓(Pipeline Stall)換取晶片面積與電池壽命。
2. 純哈佛 vs 改良型哈佛:兼顧平行度與編譯器
早期的純哈佛架構(如經典 8051)將 ROM 與 RAM 的實體與位址完全切開,讀寫代碼用 MOVC,讀寫記憶體用 MOVX。這種硬性隔離雖然消除了匯流排衝突,卻對高階語言的指標(Pointer)極不友善。
現代微處理器(Cortex-M4/M7/M85 等)則全面走向「改良型哈佛架構(Modified Harvard)」:
- 內部哈佛(Core 視角):L1 層級將指令與資料徹底分流(分立 I-Code/D-Code 匯流排或獨立 L1 I/D Cache),指令抓取與資料存取同時並行,榨乾 IPC(每週期指令數)。
- 外部馮紐曼(軟體視角):走出晶片核心、面對 L2 快取或主記憶體時,提供統一的連續位址空間,讓 C/C++ 編譯器能以單一記憶體模型流暢運作。
二、 接力賽模型:管線深度與時脈頻率的物理極限
很多人直覺認為:「頻率拉不上去,換到更先進的製程不就好了?」深入微架構後,會發現這完全違背了物理規律。
管線設計本質上就是一場「接力賽」:
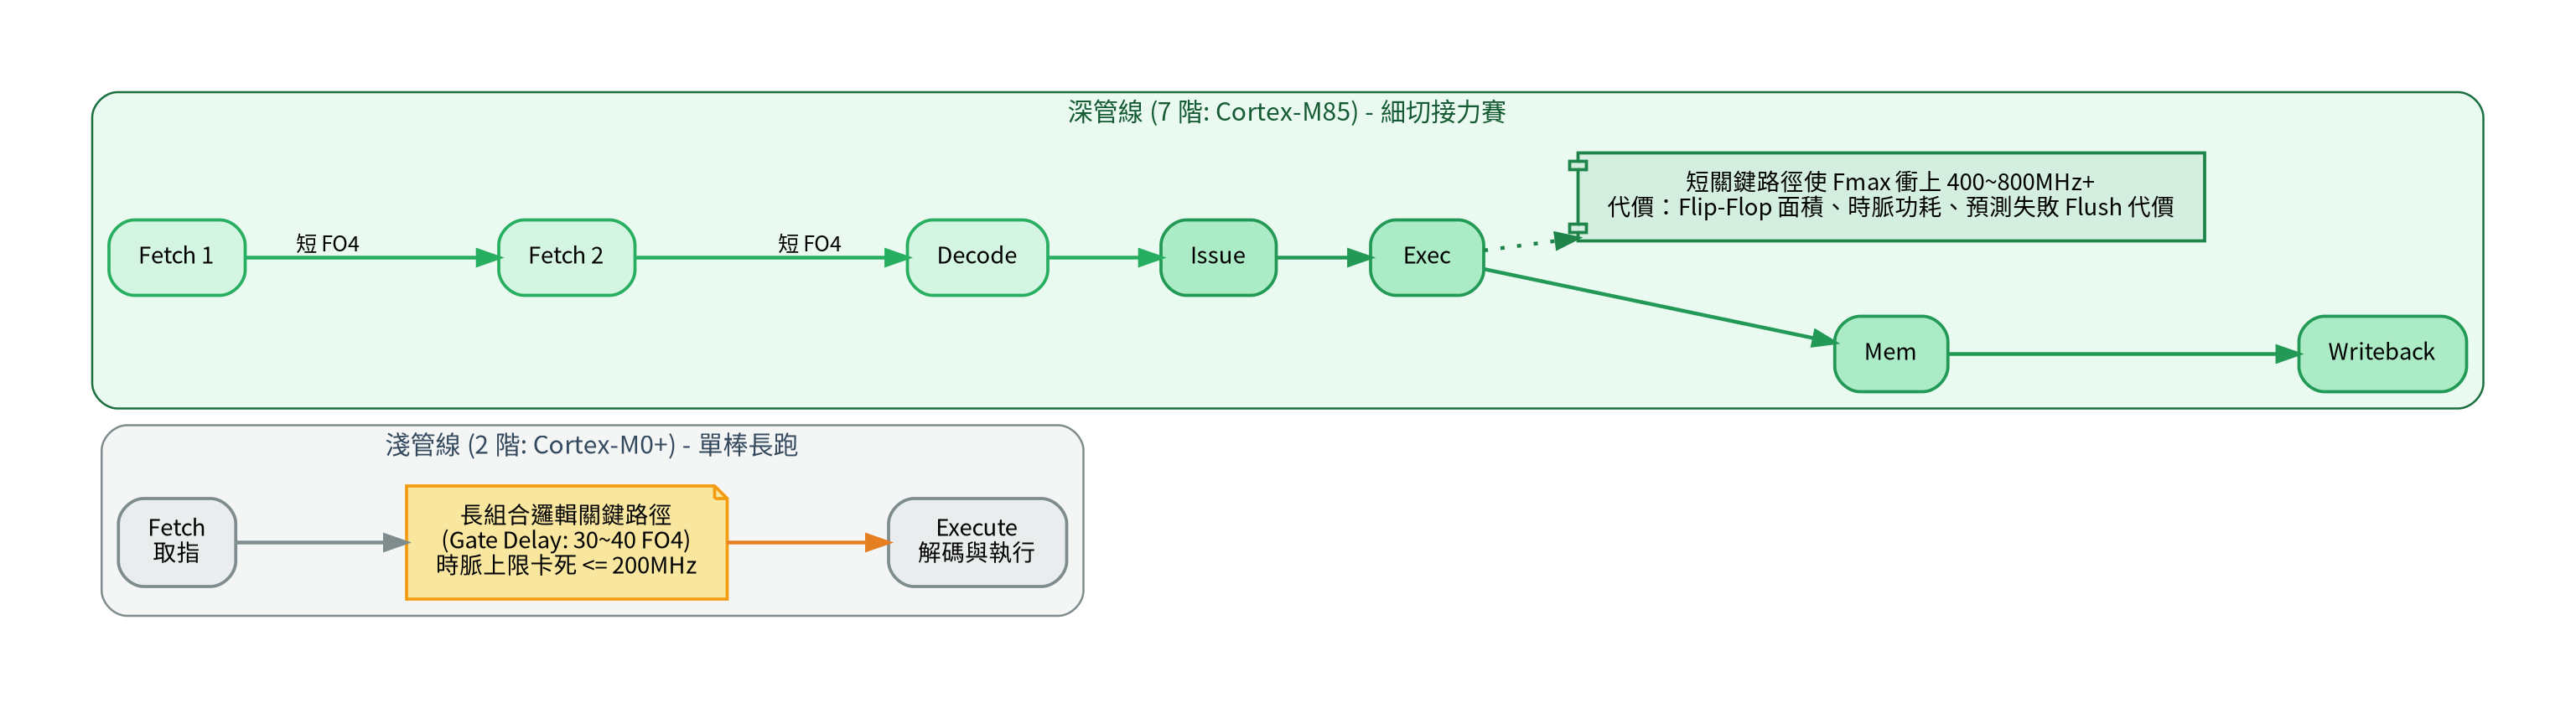
- 縮短每棒距離(加深管線):把組合邏輯關鍵路徑(Critical Path)切碎,降低每個週期需要穿透的邏輯閘層數(Gate Delay / FO4),讓時脈頻率(Fmax)得以大幅衝高。
- 棒次增加的硬性代價:每切一級就必須插入正反器(Flip-Flop),導致晶片面積與時脈樹功耗急遽增加;更致命的是一旦分支預測失敗(Branch Misprediction),整條管線清空重跑(Pipeline Flush)的時間懲罰將會倍增。
| 核心架構 | 體系結構 | 管線深度 | 匯流排與快取配置 | 40nm 下極限頻率特性 |
|---|---|---|---|---|
| Cortex-M0+ | 馮·紐曼 | 2 階 (Fetch/Execute) | 單一 32-bit AHB-Lite | 單階塞入 30~40 層邏輯閘,換製程也衝不破 200~300 MHz |
| Cortex-M4 / M33 | 改良型哈佛 | 3 階 (Fetch/Decode/Exec) | I/D/System 三匯流排分立 | 消除管線停頓,主頻約 100~200 MHz |
| Cortex-M7 | 改良型哈佛 | 6 階 (超純量雙發射) | AXI + L1 Cache + TCM | 受限於組合邏輯延遲,40nm 極限卡在約 300~350 MHz |
| Cortex-M85 | 改良型哈佛 | 7 階 (超純量雙發射) | L1 Cache + TCM + 分支預測 | 路徑切得更細,40nm 下極限頻率可達約 400 MHz (CoreMark/MHz 達 6.28) |
Cortex-M0+ 只有 2 階管線,單一階段要硬扛 30 到 40 層閘延遲。就算把它搬到 40nm、22nm 甚至是 FinFET 製程,組合邏輯與導線 RC 延遲依然鎖死了時脈天花板。製程只是放大器,管線架構才是決定頻率上限的骨架。
三、 高頻運作下的系統陷阱:快取與確定性的博弈
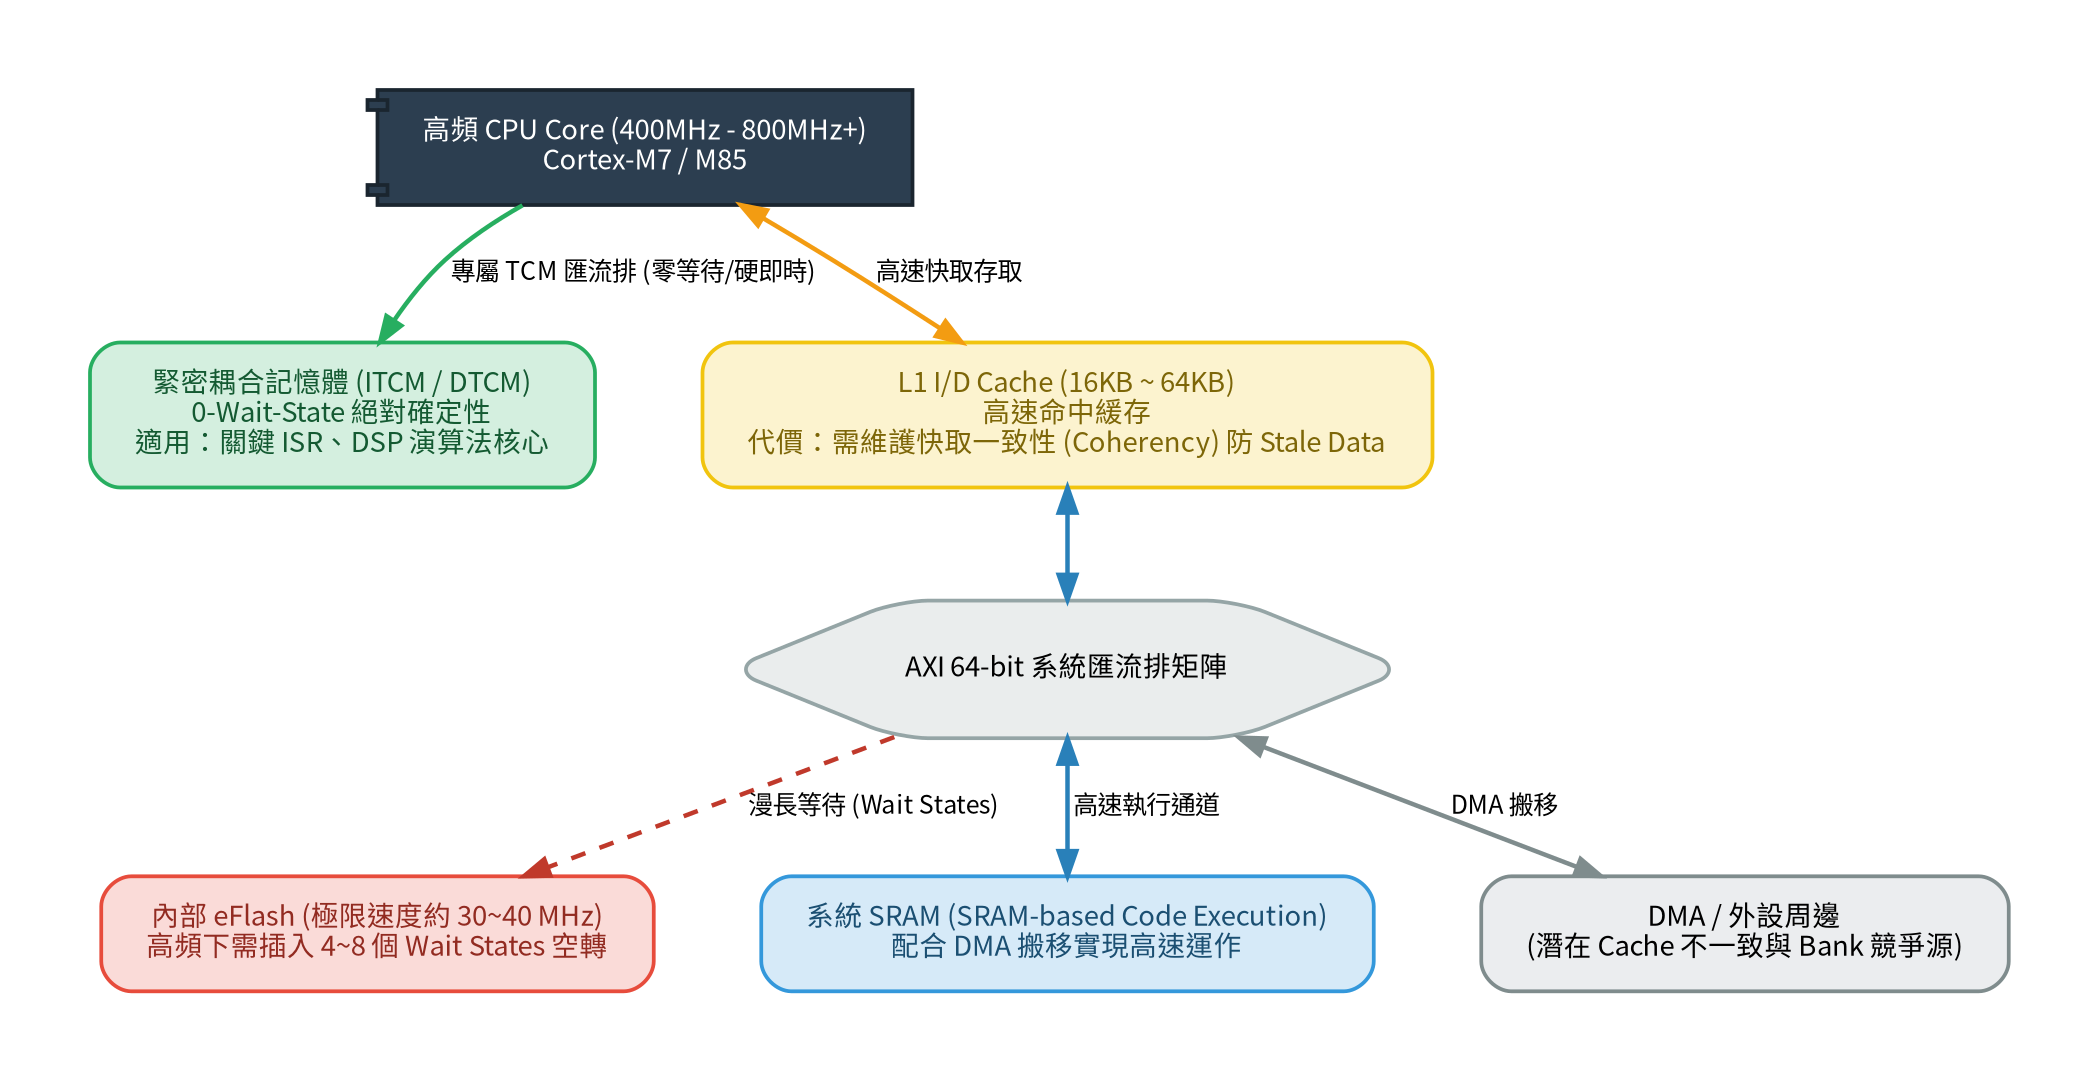
當 MCU 頻率突破 200 MHz、甚至靠 M7/M85 衝到 400~800 MHz 時,真正的架構瓶頸轉移到了記憶體:
- Flash 的龜速瓶頸:嵌入式 eFlash 實體讀取極限通常卡在 30~40 MHz。高頻運作若沒有快取支援,CPU 每個週期都得插入 4 到 8 個 Wait States,空轉等指令,算力大打折扣。
- L1 Cache 的一致性詛咒:引進 L1 D-Cache 能解決頻寬問題,卻直接破壞了嵌入式系統最重要的「快取一致性(Cache Coherency)」。當 DMA 在背景將週邊資料搬入記憶體時,CPU 讀到的可能還是 Cache 裡的髒資料(Stale Data)。此時必須透過 MPU 嚴格規劃 Non-cacheable 區段,或由工程師手動維護 Clean/Invalidate。
- TCM 的硬即時防線:為了確保中斷服務常式(ISR)與關鍵演算法擁有絕對確定性(Real-Time Determinism),架構上必須引入緊密耦合記憶體(ITCM/DTCM)。這要求工程師必須手動修改 Linker Script,在軟硬體邊界上精準配置代碼落點。
架構設計從來沒有免費的午餐,每換取一分效能,就必須承擔對應的系統複雜度。
四、 架構師思維:從晶片設計到心智模型重構
昨夜這場體系結構的梳理,帶給我最大的收穫不在於記住了多少暫存器或型號參數,而是看見了思考模式的鏡射:
- 警惕「大腦自動補丁」:未經追問與底層物理推導的理解,往往充滿了主觀假設。當我們習慣只看表面名詞(例如「哈佛比較快」),思維就永遠停留在人云亦云的層次。
- 蘇格拉底式的邊界追問:藉由不斷追問「為什麼要這樣設計?」、「它做出了什麼戰略犧牲?」、「物理邊界在哪裡?」,我們才能穿透行銷術語,看見架構背後的約束矩陣(Constrained Optimization)。
- 把知識編譯回神經網路:外部工具與 AI 提供的是即時演算的資訊流;真正的架構力,是把這些穿透後的底層原理內化、重組,燒錄進自己的大腦直覺中。
在硬體中,消除匯流排衝突需要分流;在思考上,消除認知混亂則需要穿透本質。當我們弄清楚了限制條件與代價,所有的架構選擇,便都成了順理成章的必然。